取込先の氏名欄に「10バイトまで」のような上限があると、入力チェックをVBAで書く必要が出てきます。ここで Len を使うと、判定が合いません。Len が返すのは文字数であり、バイト数ではないからです。
この記事では、全角を含む氏名のバイト数を LenB と StrConv で数える方法を紹介します。半角カナに変換する前後でバイト数がどう変わるかも、実機で確認しました。
この記事が役立つ人
- 取込データの入力チェックをVBAで書いている人
- 氏名欄にバイト数の上限がある取込先を扱っている人
LenとLenBの違いがあいまいな人
VBAのバイト数チェックは、Shift_JISに変換してからLenBで数える
文字列を StrConv(s, vbFromUnicode) でShift_JISのバイト列に変換し、LenB で数えます。全角は2バイト、半角は1バイトとして数えられます。
Function SjisBytes(ByVal s As String) As Long
    SjisBytes = LenB(StrConv(s, vbFromUnicode))
End Function

Function IsWithinBytes(ByVal s As String, ByVal maxBytes As Long, _
                       Optional ByVal narrowFirst As Boolean = False) As Boolean
    If narrowFirst Then s = StrConv(s, vbNarrow)
    IsWithinBytes = (SjisBytes(s) <= maxBytes)
End Function
SjisBytes は、変換して数えるだけの関数です。IsWithinBytes は、上限以下かどうかをTrueかFalseで返します。第3引数がTrueのときは、先に vbNarrow で半角にします。判定を関数に切り出しておけば、列ごとに上限が違っても引数を変えるだけで済みます。
vbFromUnicode は、Windowsの既定のコードページに変換します。この記事の結果は、日本語版Windows(コードページ932)で確認したものです。他の環境は未検証です。
LenとLenBは何を数えているか
Len は文字数、LenB は文字列がメモリー上で占めるバイト数を返します。VBAの文字列は内部でUnicode(UTF-16)のため、全角も半角も1文字2バイトです。
| 文字列 | Len | LenB |
|---|---|---|
| 山田太郎 | 4 | 8 |
| ABC | 3 | 6 |
| ヤマダ(半角カナ) | 4 | 8 |
半角カナも2バイトに数えられます。LenB だけでは、Shift_JISでのバイト数になりません。
StrConvで変換してからLenBで数える
StrConv(s, vbFromUnicode) を通すと、全角は2バイト、半角(半角カナを含む)は1バイトのバイト列になります。それを LenB で数えると、Shift_JISのバイト数が得られます。
| 文字列 | SjisBytes |
|---|---|
| 山田太郎 | 8 |
| ABC | 3 |
| ヤマダ | 4 |
| ヤマダ | 6 |
| 山田abc | 7 |
| (空文字) | 0 |
4つの氏名で、Len・LenB・SjisBytes・半角化後のバイト数を並べて確認します。
Function SjisBytes(ByVal s As String) As Long
    SjisBytes = LenB(StrConv(s, vbFromUnicode))
End Function

Sub Demo18()
    Dim names As Variant, i As Long, s As String
    names = Array("山田太郎", "ABC", "ヤマダ", "ヤマダ タロウ")
    For i = LBound(names) To UBound(names)
        s = names(i)
        Debug.Print s & " : Len=" & Len(s) & " / LenB=" & LenB(s) & _
                    " / SjisBytes=" & SjisBytes(s) & _
                    " / 半角化後=" & SjisBytes(StrConv(s, vbNarrow))
    Next i
End Sub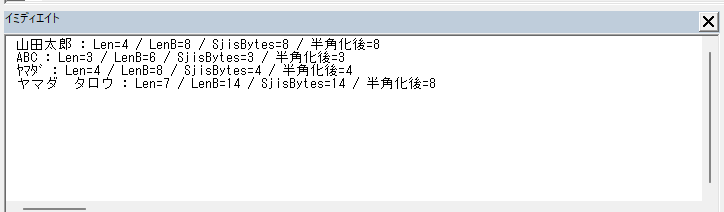
変換後の文字列に Len を使ってはいけません。バイト列が2バイトずつ詰められるため、Len は LenB の半分になります。「山田太郎」を変換した後の Len は4、「ABC」は1でした。
半角カナ変換(vbNarrow)の前後でバイト数が変わる
StrConv(s, vbNarrow) は、全角カナや全角英数字を半角にします。実測した結果は次のとおりです。
| 変換前 | 変換後 | バイト数 | 文字数 |
|---|---|---|---|
| カ | カ | 2 → 1 | 1 → 1 |
| ガ | ガ | 2 → 2 | 1 → 2 |
| パ | パ | 2 → 2 | 1 → 2 |
| ー | ー | 2 → 1 | 1 → 1 |
| ッ | ッ | 2 → 1 | 1 → 1 |
| ABC123 | ABC123 | 12 → 6 | 6 → 6 |
| 全角スペース | 半角スペース | 2 → 1 | 1 → 1 |
| 山田 | 山田 | 4 → 4 | 2 → 2 |
| やまだ | やまだ | 6 → 6 | 3 → 3 |
| ヤマダ タロウ | ヤマダ タロウ | 14 → 8 | 7 → 8 |
清音の全角カナは、半角になると半分の1バイトです。一方、濁音と半濁音は、半角にすると「カ」と「゙」のように2文字に分かれるため、バイト数は変わらず、文字数だけが増えます。漢字とひらがなは変わりません。「ヤマダ タロウ」は、文字数が7から8に増えますが、バイト数は14から8に減ります。
各定数の仕様は、Microsoft LearnのStrConv関数で確認できます。
変換前に測るか、変換後に測るか
取込先が半角カナで氏名を受け取るなら、半角にした後のバイト数で判定します。全角のまま受け取るなら、変換前で判定します。先に取込先の仕様を確認してください。
上限が10バイトの場合、「ヤマダ タロウ」は全角のままだと14バイトで超過しますが、半角にすると8バイトで収まります。
Debug.Print IsWithinBytes("ヤマダ タロウ", 10)        ' False
Debug.Print IsWithinBytes("ヤマダ タロウ", 10, True)  ' True
半角にしても超える場合があります。「ヤマダタロウヤマダ」は、半角にすると11バイトになり、上限10バイトを超えます。
よくある失敗
1. Lenで判定してしまう
「ヤマダタロウヤマダ」は9文字なので、Len(s) <= 10 を通ります。しかしShift_JISでは18バイトで、上限を超えています。
2. LenBだけで判定してしまう
半角の「ABC」が6バイトになります。半角カナの入った氏名は、実際より大きく数えられます。
3. 変換後の文字列にLenを使ってしまう
Len(StrConv(s, vbFromUnicode)) は、文字数でもバイト数でもない値になります。「ABC」なら1、「山田太郎」なら4です。
4. Shift_JISで表せない文字を見落とす
「髙」(はしご高)は、今回の環境では2バイトで数えられ、変換して戻しても同じ文字でした。一方、「𠮷」(吉の異体字)はShift_JISに含まれず、変換すると「??」に化けます。しかもバイト数は2と数えられるため、バイト数だけでは異常に気づけません。
変換して戻した文字列が元と違うかどうかで検出できます。
Function HasUnconvertible(ByVal s As String) As Boolean
    HasUnconvertible = (StrConv(StrConv(s, vbFromUnicode), vbUnicode) <> s)
End Functionサロゲートペアの文字を扱うときの注意は、ScriptControlが64bit Officeで使えない時の代替コードでも触れています。
5. 別の環境でそのまま動かす
vbFromUnicode の変換先は、PCの既定のコードページで決まります。また公式の記述では、vbNarrow は適用されないロケールで実行時エラーになります。この点は実機で確認していません。日本語版Windows以外で使うときは、結果を確認してください。
応用例
取込前のチェックを、列単位でまとめて行う場面にも使えます。氏名列を1行ずつ IsWithinBytes に渡し、超過した行に印を付ける形です。Shift_JISのCSVで取り込む場合は、文字コードの指定とあわせて確認すると安全です。CSVの文字化けについては、CSVの文字化けをEncoding指定で防ぐ方法で扱っています。
まとめ
Lenは文字数、LenBは内部表現(UTF-16)のバイト数。Shift_JISのバイト数ではない- Shift_JISのバイト数は
LenB(StrConv(s, vbFromUnicode))で数える vbNarrowで清音は半分になるが、濁音・半濁音は変わらない。変換前後のどちらで測るかは、取込先の仕様で決める- Shift_JISで表せない文字は、バイト数では気づけない。往復変換で検出する
コメント