CSVを取り込むと、文字化けすることがあります。ファイルがShift_JISなのかUTF-8なのか、分からないときです。
以前の記事「【Power Query】CSVの文字化けをEncoding指定で防ぐ方法」では、先頭のBOMの有無で判定する方法を紹介しました。ただし、BOMのないUTF-8を、Shift_JISと誤判定する限界がありました。
今回は、この限界を置換文字(�)で補えるかを試しました。結論を先に書くと、補えたのは一部です。Shift_JIS側では置換文字が出ず、想定していた「両方を数えて比べる」方法は成り立ちませんでした。
想定読者
- 取込元ごとに文字コードが違うCSVを、1つのクエリで取り込みたい人
- BOMなしのUTF-8のCSVが混ざることがある人
- 文字コードの自動判定で、何が判定できて何ができないかを知りたい人
結論
- UTF-8として読めないバイトは、置換文字(U+FFFD)になる
- Shift_JIS(932)で読むと、置換文字は出ない
- 判定に使えるのは「UTF-8で読んで、置換文字が出るか」だけ
- 英数字だけのCSVと、半角カナのShift_JISは、この方法では区別できない
検証環境は、Excel 16.0(Windows、日本語環境、コードページ932)です。他のバージョン・Mac版は未検証です。
置換文字と、最初に考えた方法
バイト列を、ある文字コードとして読めなかったとき、その位置は「�」(U+FFFD)に置き換わります。これが置換文字です。
最初は、次の方法を考えました。
- UTF-8とShift_JISの両方で読む
- 置換文字の数を数える
- 少ない方を採る
Shift_JIS側は数えられなかった
実際に試すと、Shift_JIS(932)で読んだときの置換文字は、どのファイルでも0個でした。UTF-8で作ったCSVを932で読んでも、0個です(3種類のファイルで確認)。
そこで、不正なバイトを含む短いバイト列を、両方の文字コードで読み比べました。
| バイト列(10進) | UTF-8(65001)で読む | Shift_JIS(932)で読む |
|---|---|---|
| 65 255 66 | A、置換文字、B | A、私用領域の文字(U+F8F3)、B |
| 65 129 32 66 | A、置換文字、スペース、B | A、中黒(・)、B |
| 65 129(末尾) | A、置換文字 | A、中黒(・) |
Shift_JISで読むと、不正なバイトは置換文字ではなく、中黒(U+30FB)や私用領域の文字に変わりました。2行目では、後ろのスペースまで1文字に吸収されています。ほかに、128は制御文字(U+0080)、160・253・255は私用領域の文字になりました。13パターンで確認しています。
それなら、932で読んだときの中黒を数えればよいかもしれません。そこで、5種類のファイルを932で読み、中黒の数を数えました。
- 正しいShift_JISのファイル:1個(もともと中黒を1つ含むため)
- BOMありのUTF-8:4個、BOMなしのUTF-8:3個
- 英数字だけ、半角カナのShift_JIS:0個
中黒は、正しい文字としても現れます。件数だけでは、中黒を含む正しいShift_JISと区別できません。半角カナのShift_JISは0個で、この方法でも判定できませんでした。サンプルは5ファイルだけで、境目になる件数は決められません。判定には使わないことにしました。
判定のコード
使えるのは、UTF-8側の置換文字だけです。UTF-8として読めたらUTF-8、読めなければShift_JISとみなします。
let
    Count = (t as text, ch as text) as number =>
        Text.Length(t) - Text.Length(Text.Replace(t, ch, "")),
    Detect = (buf as binary) as record =>
        let
            t8 = Text.FromBinary(buf, 65001),
            bad = Count(t8, "#(fffd)"),
            kind =
                if bad > 0 then "NotUtf8"
                else if Text.Length(t8) = Binary.Length(buf) then "AsciiOnly"
                else "ValidUtf8"
        in
            [Utf8Bad = bad, Kind = kind, Encoding = if bad > 0 then 932 else 65001],
    Buf = Binary.Buffer(File.Contents("C:\data\sample.csv")),
    Info = Detect(Buf),
    Result = Csv.Document(Buf, [Delimiter = ",", Encoding = Info[Encoding], QuoteStyle = QuoteStyle.None])
in
ResultKindは、判定の確かさを示す目印です。NotUtf8はShift_JISと判断できます。ValidUtf8は、UTF-8として読めたという意味で、Shift_JISでないとは言い切れません。
関数の仕様は、Microsoft LearnのText.FromBinaryで確認できます。
5種類のファイルで試した結果
同じ内容のCSVを、5種類作って判定しました。ReadOkは、判定した文字コードで読んだとき、見出しが正しく読めたかどうかです。
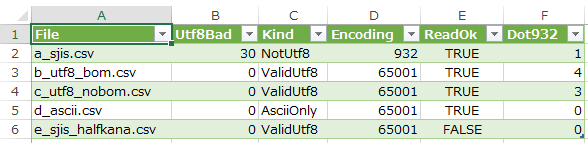
| ファイル | BOMだけで判定 | 置換文字(UTF-8側)で判定 |
|---|---|---|
| Shift_JIS | 正しく読めた | 正しく読めた |
| BOMありUTF-8 | 正しく読めた | 正しく読めた |
| BOMなしUTF-8 | 文字化け | 正しく読めた |
| 英数字だけ | 正しく読めた | 正しく読めた(どちらで読んでも同じ) |
| 半角カナのShift_JIS | 正しく読めた | 文字化け |
BOMだけの判定は、同じ種類のファイルで別に確認した結果です。
BOMなしのUTF-8は、置換文字を使うと正しく読めました。以前の記事で挙げた限界は、この点で補えています。
一方で、半角カナのShift_JISは、置換文字を使うと文字化けしました。バイト列がUTF-8として読めてしまい、置換文字が出ないためです。BOMだけの判定では、このファイルは正しく読めました。
よくある失敗
1. 両方の置換文字を数えて比べる
Shift_JIS側が常に0個のため、比較になりません。数えるのはUTF-8側だけです。
2. 同数のときに、黙って決める
両方0個のときに、先頭の候補を採ると、誤っていても気づけません。今回の半角カナがその例です。
3. BOMだけで決める
BOMなしのUTF-8を、Shift_JISと決めてしまいます。置換文字を併用すると防げます。
4. 判定の確かさを確認しない
ValidUtf8のファイルは、半角カナのShift_JISが混ざっていても区別できません。取込後に、文字を目で確認する運用が安全です。
応用例
Detectはファイル単位で呼び出す関数です。フォルダ内の複数のCSVに適用して、Kindの一覧を見る使い方ができます(この使い方は未検証です)。
Shift_JISで表せない文字の扱いは、「【VBA】全角氏名のバイト数チェックはLenBとStrConvで行う」で整理しています。
同じ年月のCSVが版を変えて溜まっているときに、最新の版だけを読む方法は、【Power Query】年月ごとにCSVの最新版だけを採用するで扱っています。
BOM付きUTF-8のCSVを書き出す側は、【VBA】BOM付きUTF-8のCSV書き出しと、URLパスの検知で扱っています。
まとめ
- UTF-8側の置換文字だけが、判定に使える
- Shift_JIS側は、置換文字が出ないため数えられない
- BOMなしUTF-8は補えたが、半角カナのShift_JISは判定できない
- 判定の確かさを示す目印(
Kind)を残し、取込後に確認する
未検証の項目は、EUC-JP・UTF-16・他のロケール・Mac版・大きなファイルでの速度です。
コメント